När AI-koden kör fast: statistik handlar mer om ställda frågor än kod

Under det senaste året har en ny kategori av förfrågningar blivit allt vanligare i min inkorg. Det är forskare, analytiker och företagare som skickar över ett R-skript som uppvisar kryptiska felmeddelanden, ger orimliga resultat eller som de helt enkelt känner en växande osäkerhet inför. Gemensamt för nästan alla dessa fall är att koden från början skrivits av en AI-assistent.

Det råder ingen tvekan om att språkmodeller och AI-verktyg har förändrat hur vi kodar. Att snabbt få förslag på syntax, transformera om en datatabell eller felsöka ett ilsket kommatecken kan spara enormt mycket tid. Som ett komplement i vardagen är AI-assistenter fantastiska. Men när verktyget får ta över ratten helt utan att föraren kan vägens grundläggande regler uppstår snabbt problem.

För att skriva fungerande R-kod räcker det sällan med att bara be en chatbot generera ett skript. Du måste förstå den underliggande logiken för att kunna läsa koden, modifiera den och framför allt förstå varför den gör som den gör. När ett skript kraschar krävs det att du förstår datastrukturer, paketberoenden och funktionsargument för att leda AI:n rätt igen, snarare än att bara klistra in felmeddelandet i en evig loop. Denna grundläggande hantverksskicklighet är anledningen till att jag lägger så stor vikt vid fundamentet i mina kurser och i min bok Modern Statistics with R. Med en stabil grund blir AI-assistenten en kraftfull medhjälpare; utan den blir den en källa till subtila fel som kan ta dagar att upptäcka.

Men kodsyntaxen är i själva verket bara den första och lättaste tröskeln. Det djupare problemet uppstår när vi förväntar oss att AI-assistenten ska stå för den statistiska analysen.

En betydande del av mitt arbete som statistikkonsult handlar inte om att skriva kod överhuvudtaget. Det handlar om att ställa det som ibland kan verka som ”dumma frågor”. Hur samlades data in? Vad hände den där tisdagen då hälften av mätvärdena saknas? Är observationerna verkligen oberoende av varandra? Vilka undantag och märkligheter döljer sig bakom de städade kolumnnamnen?

AI-modeller saknar den domäninsikt och den kritiska skepticism som krävs för att genomskåda ett dataset. Tvärtom: de har förutfattat meningar utifrån gamla exempel de sett och lyckas inte upptäcka när data motsäger deras förväntningar. AI-modeller bygger på mönsterigenkänning från existerande text och kod, vilket ofta innebär att de rutinmässigt föreslår de mest välkända och standardiserade metoderna – oavsett om förutsättningarna för dem är uppfyllda eller inte.

När en kund kommer till mig med en idé om att köra en specifik standardanalys som AI:n rekommenderat, visar det sig mycket ofta efter en närmare granskning att vi måste välja en helt annan väg. Kanske har data en skev fördelning, en hierarkisk struktur eller mätfel som gör standardmodellen direkt missvisande. Att identifiera detta kräver statistisk intuition och erfarenhet – egenskaper som inte går att prompta fram.

AI kan hjälpa dig att skriva koden snabbare, men den kan inte ta ansvaret för att rätt modell används på rätt sätt för rätt fråga. Om du vill bygga en hållbar kompetens i R och statistik handlar det därför om att investera i förståelsen. När du behärskar grunderna blir AI:n precis vad den borde vara: en effektiv assistent, inte en osäker metodexpert.

Statistik för alla

Vi är inte direkt bortskämda med populärvetenskapliga böcker, tv-program och poddar om statistik. Nu gör Sveriges radio en insats på området med programmet Vilse i statistiken, där professor Tom Britton (känd för sina tålmodiga förklaringar av covidstatistik under pandemin) agerar expert. Avsnitten är runt tio minuter långa och går att höra på radion, på sverigesradio.se och där poddar finns.

Ett annat fint exempel på svenskledd populärstatistik är (den nu mer än tio år gamla) dokumentären The Joy of Stats med Hans Rosling, som finns på Gapminders webbplats.

En favorit på området är annars den norska dokumentärserien Siffer, som handlar om statistik, sannolikhetslära och matematik. Några av avsnitten finns på seriens Youtubesida.

Fotbollsoraklet i Oberhausen

Idag drar fotbolls-EM för herrar igång – ett år försenat. Många sitter nog just nu och försöker tippa resultaten. Somliga lusläser fotbollsstatistik, andra går på magkänslan, och någon kanske gör som jag gjorde för det svenska innebandyslutspelet förra året och tar fram en statistisk prediktionsmodell.

Men det finns en metod som är bättre än alla ovanstående: att låta en bläckfisk tippa resultaten. Bläckfisken Paul vid Sea Life Center i tyska Oberhausen blev en internationell kändis under fotbolls-VM 2010, då han tippade rätt i 8 av 8 matcher.

Hade Paul bara tur, eller var han ett tipsorakel av rang? Ett vanligt sätt att statistiskt utvärdera en hypotes är p-värden. De mäter hur starka bevisen för att en hypotes är felaktig är. Hypotesen som testas brukar kallas nollhypotesen. Om nollhypotesen inte stämmer så gäller istället en alternativhypotes. Den något torra definition av p-värdet är att det är sannolikheten för ett resultat som är minst lika extremt som det observerade, i riktning mot alternativhypotesen. Om p-värden hamnar under en på förhand bestämd gräns – ofta 0,05 – så säger man att resultatet är signifikant eller statistiskt säkerställt och anser sig ha belägg för att det är alternativhypotesen som stämmer.

I fallet med bläckfisken Paul så kan vi undersöka nollhypotesen att Paul bara gissade blint. Alternativhypotesen är att han på något sätt faktiskt kunde förutse resultaten i matcherna. Om vi även räknar in de matcher han tippade i EM 2008 (4 rätt på 6 matcher) så har vi att han tippade rätt i 12 matcher av 14 möjliga. p-värdet blir då sannolikheten att tippa minst 12 rätt (”ett resultat som är minst lika extremt som det observerade”) när man tippar 14 matcher. Om nollhypotesen stämmer så borde Paul ha samma chans att tippa rätt som man skulle få om man singlade slant. Vi kan då räkna ut p-värdet, som blir 0,0065. Det ligger långt under gränsen 0,05 och därmed är det alltså statistiskt säkerställt att Paul hade förmågan att förutse resultaten i fotbollsmatcher.

Det finns två slutsatser man kan dra av exemplet med Paul. Den första slutsatsen är att man aldrig ska nöja sig med en enda studie som visar att något är statistisk säkerställt. Det finns alltid en risk att p-värdet blir lågt av ren slump, datafel, felräkningar eller brister i försöksupplägget. Därför behövs nya försök och upprepningar av studier innan man kan säga något med säkerhet.

Den andra slutsatsen? Man ska aldrig underskatta en bläckfisk.

Vad betyder resultatet av ett antikroppstest?

I takt med att allt fler har drabbats eller tror sig ha drabbats av covid-19 så växer intresset för antikroppstester, som man hoppas ska visa om man har haft sjukdomen eller inte. Olika aktörer erbjuder olika sorters antikroppstester, och alla möjliga siffror nämns i sammanhanget: 99,2 % säkerhet, 93 % sensitivitet, 99 % specificitet – och så vidare. Vad innebär det egentligen – och kan man lita på testens resultat?

När medicinska tester utvärderas finns två mått som man brukar utgå från:

  • Sensitivitet: sannolikheten att testet ger ett positivt resultat för en person som har haft sjukdomen.
  • Specificitet: sannolikheten att testet ger ett negativt resultat för en person som inte har haft sjukdomen.

Man önskar sig att både sensitivitet och specificitet ska vara så höga som möjligt. Låg sensitivitet gör att många som har haft sjukdomen felaktig får beskedet att de inte har haft det, och låg specificitet gör att många som inte har haft sjukdomen felaktig får beskedet att de har haft den – vilket i fallet med coronaviruset förstås kan vara väldigt problematiskt. Tyvärr finns det inga tester som har 100 % sensitivitet och specificitet – det finns alltid en risk för ett felaktigt svar – men det finns tester som åtminstone kommer nära.

För att ta reda på hur hög sensitiviteten och specificiteten hos olika tester är behöver man göra studier där man använder testen dels på personer som har haft sjukdomen och dels på personer som inte har haft sjukdomen, och kontrollerar om testet gav rätt svar. Ett problem är att det krävs ett stort antal personer för att få en bra uppfattning om hur hög sensitiviteten och specificiteten hos ett test faktiskt är.

Ett exempel på svårigheterna kan ses i en uppmärksammad svensk studie där en forskargrupp från Uppsala universitet utvärderade så kallade snabbtest för antikroppar mot covid-19. Bland de 29 personer som haft sjukdomen fick 27 ett positivt testresultat, vilket motsvarar en sensitivitet på 27/29 = 93,1 %. Problemet är att när så pass få patienter undersöks så finns en risk att man råkar överskatta sensitiviteten – att man av ren slump råkade få fler positiva svar än vad man kan förvänta sig. Statistiska verktyg – hypotestester och konfidensintervall – kan då användas för att få ett mått på osäkerheten i resultaten. I det här fallet så är studiens resultat bara tillräckliga för att säga att sensitiviteten är högre än 74 %. Det finns alltså inga statistiska belägg för att säga att sensitiviteten inte är 75 %, 80 % eller 85 %. Vilket tyvärr inte hindrar företaget som säljer testet från att påstå att sensitiviteten är betydligt högre än så.

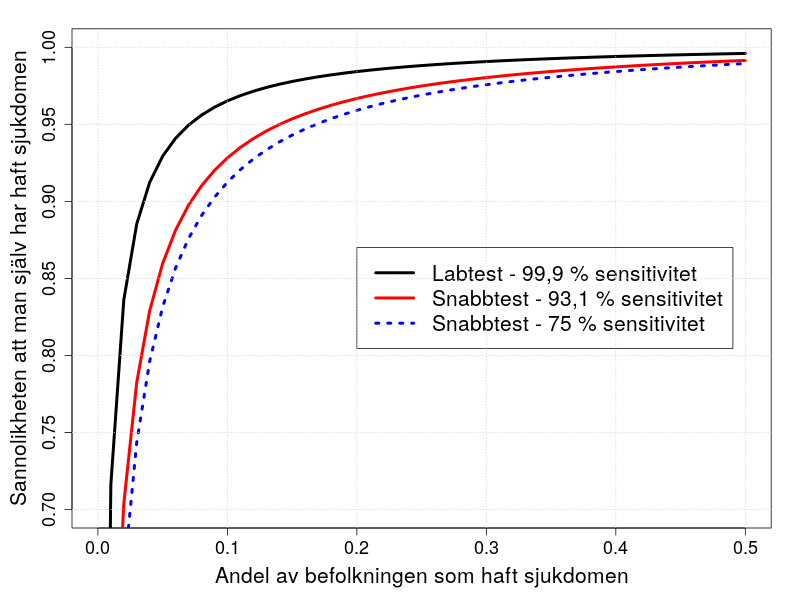
Vad betyder då resultaten man får från ett test? Svaret är att det beror på hur spridd sjukdomen är i befolkningen. Om ingen har haft sjukdomen så kommer exempelvis 100 % av de positiva resultaten att vara falska positiva, dvs. felaktiga positiva resultat. Ett labtest (som till skillnad från snabbtesten ger svar efter några dagar istället för efter några minuter) som används flitigt i Sverige uppges ha 99,6 % specificitet och 100 % sensitivitet (vilket knappast stämmer, så låt oss räkna med 99,9 % sensitivitet istället). Det innebär att om 1000 personer som inte haft sjukdomen testar sig så får 4 felaktigt ett positivt resultat, och om 1000 personer som har haft sjukdomen testar sig så får 1 felaktigt ett negativt resultat. Om man får ett positivt resultat och vet hur stor andel av befolkningen som har haft sjukdomen så kan man beräkna sannolikheten att man själv har haft den:

Om 7 % av befolkningen i en region har haft sjukdomen så kommer 95 % av de som får ett positivt resultat i ett labtest att ha haft sjukdomen, och 90 % av de som får ett positivt resultat i ett snabbtest. Om 20 % har haft sjukdomen blir motsvarande siffror 98,4 % och 96,7 %. Ett positivt resultat betyder alltså att det är troligt, men inte säkert, att man har haft sjukdomen. (Jag utgår då från att personer som haft och inte haft sjukdomen är lika benägna att testa sig.)

Inte krångligt nog? I fallet med covid-19 har det visat sig att många personer inte utvecklar antikroppar efter genomgången infektion, vilket gör resultaten av antikroppstesten ännu osäkrare. Fortfarande inte krångligt nog? I så fall kan det vara bra att ha i åtanke att antikroppar inte är samma sak som immunitet. Man kan ha antikroppar mot en sjukdom utan att vara (fullständigt) immun eller vara immun mot en sjukdom utan att ha antikroppar – de är bara ett av immunförsvarets verktyg mot virus. Ett negativt antikroppstest behöver därför inte nödvändigtvis betyda att man inte är immun, på samma sätt som att ett positivt resultat inte behöver betyda att man är immun eller inte kan sprida smittan till andra. Det finns fortfarande mycket vi inte vet om covid-19, och tills vidare finns inget annat att göra än att fortsätta följa Folkhälsomyndighetens rekommendationer – oavsett resultatet på ditt antikroppstest.

Vem tar SM-guldet?

Coronaviruset har påverkat alla delar av samhället – inklusive sportens värld. I Sverige fick bland annat innebandyns slutspel ställas in. Serievinnarna IKSU (dam) och Falun (herr) tilldelades SM-guldet. Men hur sannolikt är det egentligen att de faktiskt hade vunnit slutspelet?

Jag har för Innebandymagazinets räkning tagit fram en modell som förutspår hur innebandyns slutspel borde ha slutat. Modellen bygger på matchresultat från de senaste två säsongerna och tar med olika parametrar hänsyn till hur bra de olika lagen är, dels på hemmaplan och dels på bortaplan. Med hjälp av modellen kunde jag sedan simulera slutspelet 1 000 000 gånger, för att se hur troliga olika resultat var.

Det finns mycket som påverkar resultatet i en match, och allt kan inte sammanfattas med siffror. Men däremot är det fullt möjligt att skapa modeller som säger hur sannolikt det är att olika lag vinner, samt vilka resultat som är mest troliga. Och det fungerar faktiskt – när vi testade min modell på förra årets herrslutspel så prickade den in rätt vinnare i samtliga kvarts- och semifinaler.

Innebandymagazinet kommer att släppa resultatet som modellen förutspår dag för dag fram till det som skulle ha varit finaldagen – den 25e april. För egen del ser jag fram emot att läsa vad spelare och tränare tycker och tänker om modellens resultat. De första artiklarna finns uppe redan nu:

Intresserad av prognosmodeller? Jag erbjuder konsulttjänster, föredrag och utbildningar inom området. Kontakta mig för att få veta mer.